用 Docker 自建在线阅读服务:把 Legado 书源搬进 Reader
追连载最烦的不是等更新,是换一本小说就要重装一个 App、看一遍开屏广告、被推荐流喂一堆不想看的东西。
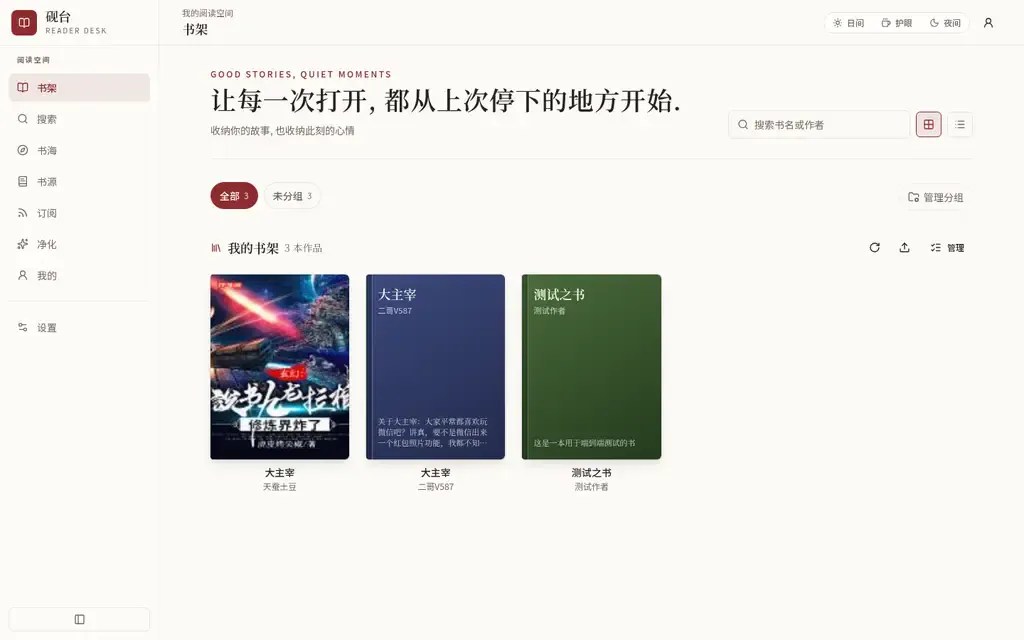
reader 换了个思路:书源在你手里,书架在你手里,进度也在你手里。 它把 legado 的书源规则搬进一个 Rust 单容器里,多源并发搜索、换源、整书缓存、离线词典、TTS 朗读全部跑在自己的机器上,不依赖第三方账号或云服务。
技术栈是 Rust(axum)+ React,数据存 SQLite 单文件,对外只开一个端口。反代、域名、公网 IP 都不是必需的。

它到底是什么
一句话:自托管的在线阅读服务,兼容 legado 书源生态。
如果你用过「阅读」(legado)这款安卓 App,理解成本几乎为零——书源规则语义、@put/@get 变量、CSS/JSONPath/XPath/正则/JS 沙箱都沿用同一套。区别在于 reader 是浏览器访问的 Web 服务,PC、手机、平板都能开,书架和进度在服务端统一。
如果你没用过,可以理解为:自己搭一个私人书库网站,搜索、阅读、书架、换源全在网页里完成,数据不出自己的硬盘。
核心功能
| 模块 | 能力 |
|---|---|
| 多源搜索 | SSE 流式逐源推送、进度可见;置信度排序、6 小时死源跳过、相关性收口,可隐藏 0 章结果 |
| 规则引擎 | legado 规则:CSS / JSONPath / XPath / 正则 / JS 沙箱,@put/@get 书级变量贯通搜索→详情→目录→正文 |
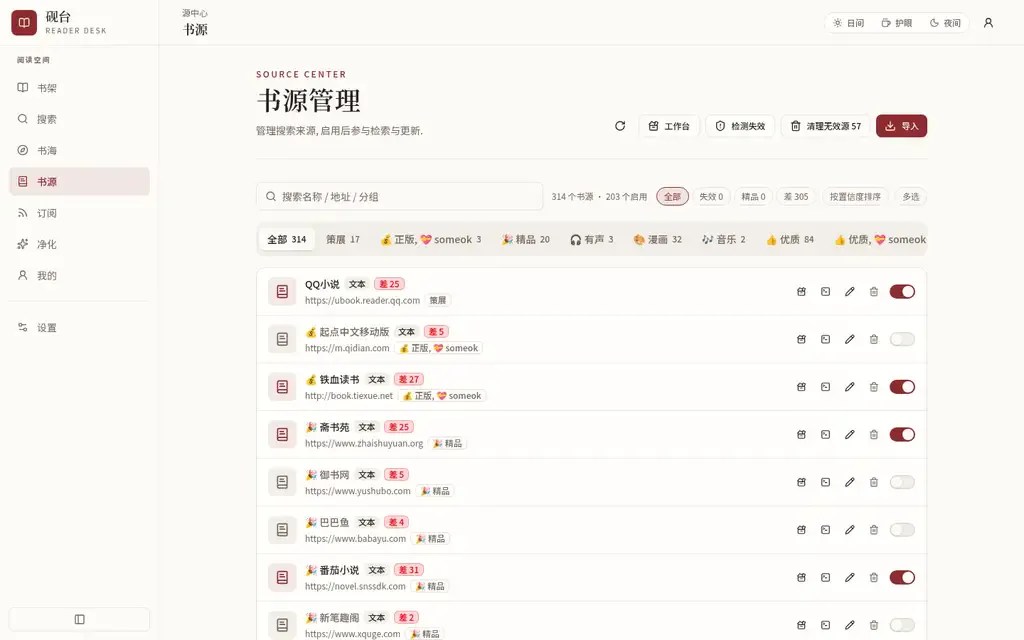
| 书源治理 | 增删改查、启停分组、导入导出、逐规则 SSE 调试工作台、失效源标记 |
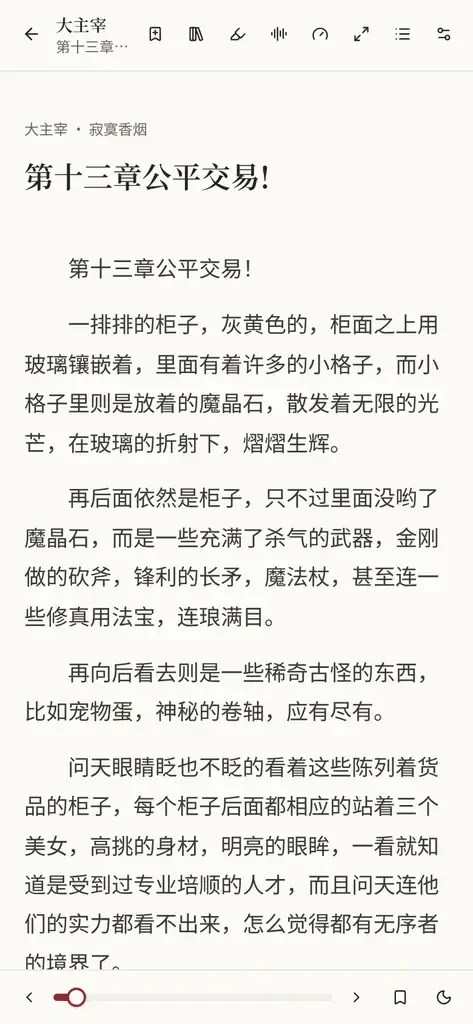
| 阅读器 | 主题/字号/行距/沉浸模式、键盘翻页、书签与批注、进度多端同步 |
| 书架 | 分组、网格/列表、未读角标;搜索列表有会话快照,返回即恢复、可续搜 |
| 换源 | 书架书走后端换源并保留进度;未入架的书纯前端切换,不动书架 |
| 多级缓存 | 目录 24h、正文永久、书籍信息 24h;缓存命中路径 4–13ms;支持单章重拉与分类清理 |
| 本地书 | epub/txt/mobi/azw3/pdf/fb2/docx/cbz/umd 自动导入,可导出 TXT/EPUB |
| 离线词典 | ECDICT 英汉 77 万词条 + 新华字典,划词即查,零网络零密钥 |
| TTS 朗读 | 接自建网关(edge-tts 或云厂商),不装则降级浏览器语音 |
| 多用户与安全 | 命名空间隔离、邀请码注册、token 鉴权、SSRF 防护 |
| 前端零外依赖 | Noto Serif/Sans SC 按 unicode-range 切 606 个子集自托管,字体不走 CDN |
| AI 阅读助手(可选) | 只检索本机已缓存章节,答案标注章节出处 |

三分钟部署
有 Docker 就能跑。
git clone https://github.com/hehecat/reader.git
cd reader/deploy
docker compose up -d
打开 http://<机器IP>:8080,注册即可用。默认单用户模式,连 .env 都不用建。
不想用 compose 也行:
docker run -d --name reader -p 8080:8080 \
  -v "$PWD/data:/storage/storage" -e READER_APP_WORKDIR=/storage \
  ghcr.io/hehecat/reader:latest
数据全在挂载目录的 storage/ 下:reader.db 主库,加上封面、本地书和 WebDAV 备份。启动前会自动打快照,保留 5 份。
第一次用,必须做这一步
导入书源。 仓库不自带任何书源,这是明确的版权考虑。
侧边栏「书源」→「导入」,粘贴 legado 书源 JSON 或填远程地址。之后流程是:
- 搜索:输入书名,多源 SSE 流式出结果,随时可以停。
- 阅读:点结果直接读,不会自动进书架。
- 收藏:想留下再点「加入书架」。

书源失效是常态——站点改版,规则就老化。书源页能看到每个源的置信度、成功率和延迟,支持「检测失效」批量筛查和「清理无效源」,单条规则还能进工作台调试。
常用配置
完整清单在仓库 docs/configuration.md,日常改这几个够了:
| 变量 | 默认 | 说明 |
|---|---|---|
READER_PORT |
8080 | compose 映射到宿主机的端口 |
READER_APP_SECURE |
false | 多用户模式开关 |
READER_APP_INVITECODE |
- | 多用户注册邀请码 |
READER_TOC_CACHE_TTL_MS |
86400000 | 目录缓存 24 小时 |
READER_HTTP_RETRIES |
2 | 单源重试次数,compose 默认 1,死源排空更快 |
READER_AI_BASE_URL / READER_AI_API_KEY |
空 | 两个都非空才启用 AI 面板 |
READER_BROWSER_FIRST |
1 | 抓取优先走浏览器反检测,compose 默认 0 |
开多用户:
cp .env.example .env
# 设 READER_APP_SECURE=true 和 READER_APP_INVITECODE=<邀请码>
docker compose up -d
有个细节做得不错:设置页的「单源搜索超时」(3–60 秒)改了立即生效,不用重启,随每次搜索请求下发。
性能实测
作者在 4 核机器上直连后端测的,缓存命中路径,三次取中位数:
| 功能点 | 时延 |
|---|---|
| 书架 / 分组 / 书签 | 2–5ms |
| 详情 / 目录 / 正文(缓存命中) | 4–13ms |
| 书源全量 / 轻量 / 统计 | 100 / 50 / 18ms |
| 搜索首结果(缓存词 / 新词) | 约 1.7s |
| 页面加载(书架 / 搜索 / 书源 / 书海) | 1.0–1.7s |
| 外部请求 | 0(字体、资源全本地) |
数据是作者自测,换机器会有差异,但量级清晰:本地缓存命中是毫秒级,慢在外部源站。 这也解释了为什么搜索慢的时候调低超时比换服务器有用。

三个可选组件
TTS 朗读:阅读器走独立网关,单文件 Python 脚本:
pip install edge-tts
python3 tts-gateway.py        # 默认 :9912
引擎默认 edge-tts(免费云神经音,中文音色内置筛选),也能配腾讯、阿里、火山的密钥。不装网关就自动降级成浏览器语音。
离线词典:镜像默认内置 ECDICT 英汉 + 新华字典(MIT)。首次启动后台导入成 dict.sqlite,之后查词毫秒级,导入期间会提示「查询中」并自动轮询。不需要的话构建时加 --build-arg WITH_DICT=0,镜像小约 130MB。
camoufox:反爬求解已内置(pip 包 + Firefox 二进制),遇验证码或 Cloudflare 质询自动 spawn。但镜像不内置浏览器二进制(约 600MB,容器内兼容性不可靠),需要浏览器自动登录得在宿主机跑:
pip install camoufox && python -m camoufox fetch
python scripts/camoufox_solver.py
再给容器设 READER_CAMOUFOX_URL=http://<宿主机IP>:<端口>。
反代:默认不需要,需要时注意两条硬要求
容器单端口直服前端和全部 API,局域网或内网穿透直接用。只有上公网要 HTTPS 时才需要自备反代,此时:
- SSE 路径不能压缩、要关代理缓冲(
/reader3/*SSE),否则流式搜索直接失效,表现是「永远找到 0 本」。 - HTML 永不缓存(
/和/reader3/*必须 no-cache),只允许缓存/static/*(哈希产物,容器已发 immutable)。给 HTML 加缓存会出现旧 index.html 引用旧 chunk 哈希,导致整页 404——这是最常见的翻车点。
/assets/* 是用户封面存储路由,别加 immutable。容器自身已发正确的缓存头,无反代时天然自洽。
升级与回滚
cd deploy && docker compose pull && docker compose up -d   # 升级
docker compose up -d reader@sha-<旧sha>                    # 回滚
镜像标签有 latest(main)、main、sha-<full>、semver。数据在挂载目录,升级不丢;启动前快照还能再退一层。想完全脱离 GHCR 自己构建,仓库根目录 docker build -t reader . 即可。
适合谁,不适合谁
适合:习惯 legado 书源、想统一管理书架和进度、不接受广告和推荐流、有能力跑一个 Docker 容器的自托管玩家。多用户模式开着,还能给家里人各开一个独立书库。
不适合:完全不想碰命令行的人(虽然有 compose,但排障要看日志);期待"装上就有书"的人(仓库刻意不带书源);只用一台手机、觉得 web 版不如原生 App 顺手的人。
几点要提前知道
- 仓库没有声明开源协议。 GitHub 上 license 字段为空,意味着默认保留所有权利。自己部署使用没问题,想二次分发或商用先联系作者。
- 书源要自备,且来源合法性由使用者自己负责。 项目只提供规则引擎,不提供内容。
- 抓取依赖反检测,源站加强风控时可能需要调
READER_BROWSER_FIRST或配 camoufox,不保证一直能抓。 - 项目较新(2026 年 9 月创建),27 星、5 个 fork,属于个人项目活跃维护阶段,接口和配置会变,升级前看 commit。
参考链接
- 项目仓库 hehecat/reader
- 配置与部署文档
- 运维文档(排障、升级回滚、性能基线)
- legado 阅读:书源规则语义与生态来源
- hectorqin/reader:项目起点
相关文档
评论与补充0
有问题或想补充的,写在下面 · 选中正文文字再点「报告错误」会自动引用还没有评论。有疑问、补充,或者发现错字,都可以写在下面。